基于 Magic-Brain 的 In-Context Visual Guidance 实践
VLA 模型的语言跟随能力始终是个问题。从大部分失败案例来看,问题不在动作本身,而是无法跟随语言指令。但是我们发现,VLA对于视觉的跟随能力较强。所以我们在Magic-Brain中的解法是:使用VLA作为抓取工具,并在它前面加一层视觉引导,让上层的 VLM Agent 框出目标,再由分割模型把框细化成三色 mask,再将三色mask画回观测图像。将语义引导转变为视觉引导,同时mask的颜色包含了时序信息,也提供了一定的记忆增强。在 MolmoSpaces-Bench 上,这个改动把magicVLA的抓取成功率从 70% 推到了 94.4%。
这篇文章会介绍我们为什么这么做、具体怎么做,以及这套设计跑在 Magic-Brain 框架的哪个位置。
1. 视觉引导:让 VLA 看见该抓什么
1.1. 为什么语言指令不够
纯语言指令让 VLA 做两件对于其比较困难的任务:先理解”苹果”这个词,再在像素里找出哪个是苹果。VLA 在动作学习上已经很强,但把名词短语绑定到图像区域,是它训练信号最稀疏的一环。我们的失败统计印证了这点:抓失败的案例里,绝大多数不是抓不稳,而是抓错对象或者放错位置。
In-Context VLA 的工作给了更系统的证据:让 VLA 自由生成文本推理(CoT)反而会损害低层控制。原因很具体:模型写出来的理由和画面里的物体对不上号(缺少 grounding),生成文本的延迟打断了控制闭环,训练目标一冲突,策略就学会了"解说动作"而不是"做好动作"。他们的结论是,VLA 缺的不是"说"的能力,而是直接拿到"目标在哪"这类现成信息的能力。这和我们的判断一致:与其等 VLA 自己学会从文字里找物体,不如换个分工——找目标交给擅长看图的 VLM,做动作交给 VLA。差别在于,我们把"目标在哪"直接画进观测图像,VLA 看图就拿到了答案,连读文字这一步都省了。
1.2. Agent 出 bbox,CV 模型出 mask
管线是两段式。第一段,上层 VLM Agent 读取当前观测图像和任务描述,靠 in-context learning 输出目标物体的 bbox:prompt 里放几个Few-shot示例,不做任何微调。第二段,bbox 交给下游的 SAM 类分割模型,把粗糙的矩形细化成像素级 mask。
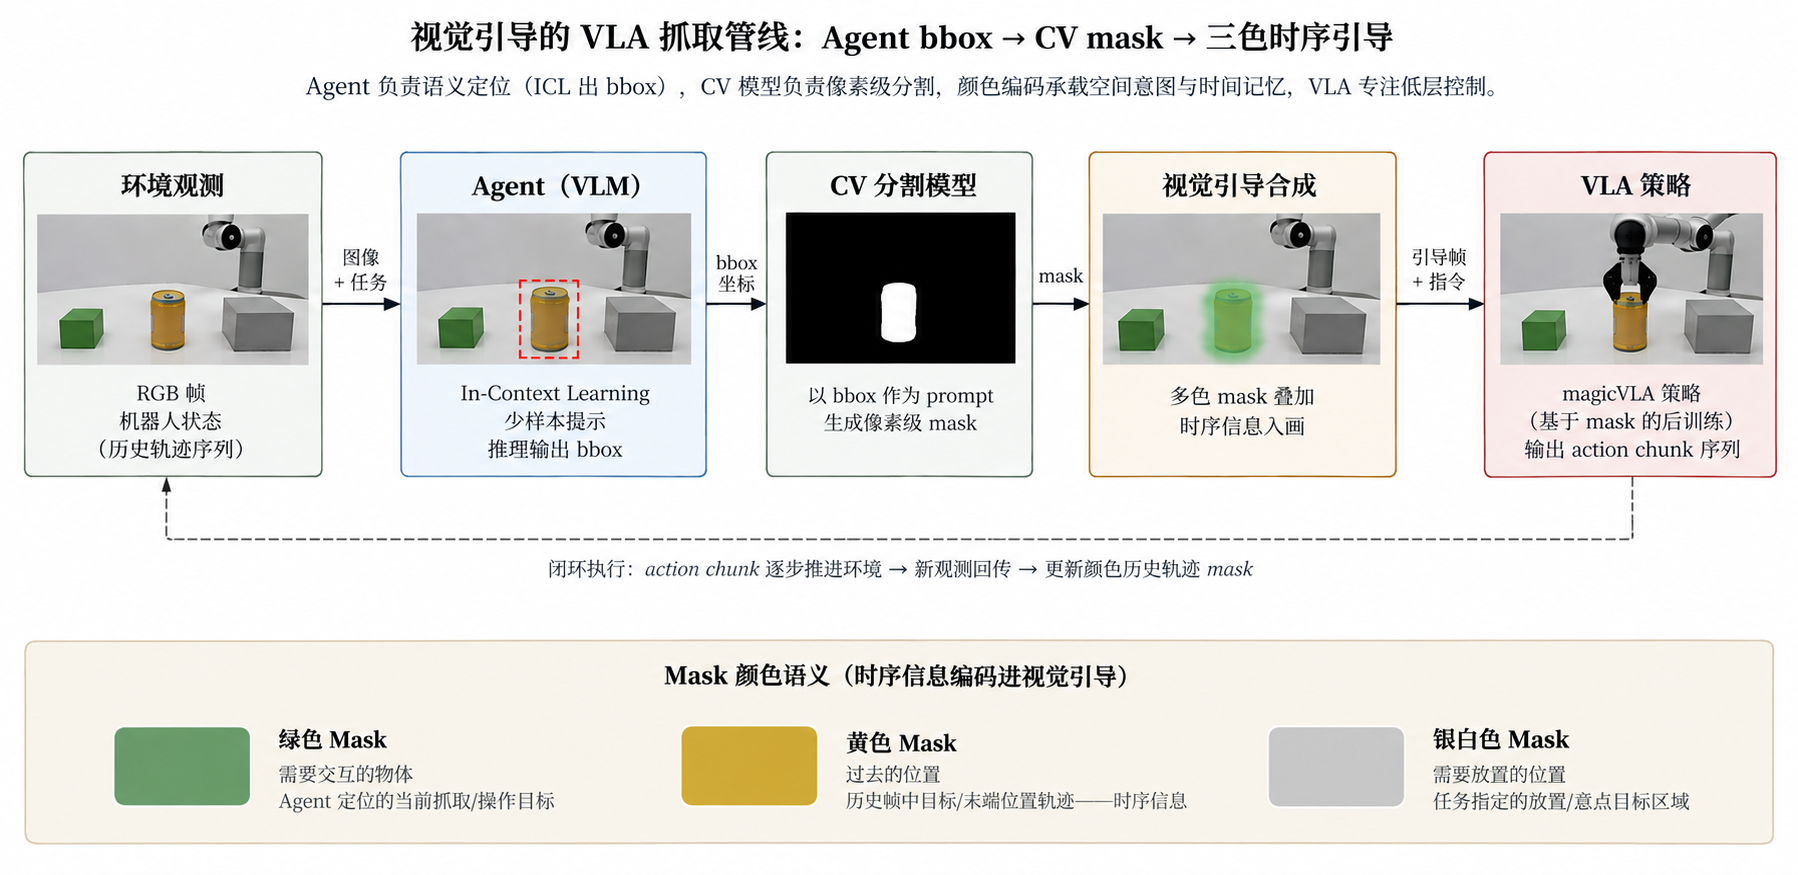
视觉引导管线
图 1 · 视觉引导管线:环境观测 → Agent ICL 输出 bbox → CV 分割模型输出 mask → 三色合成 → 引导帧送入 magicVLA
为什么选择该方案?原因有二。其一,"把视觉标记叠加在图像上,作为 VLA 的输入接口"这条路线已被验证:VP-VLA 让 System 2 的 VLM 规划器把目标位置和放置区域以准星、bbox 的形式叠加到观测图像上,System 1 控制器则利用这些视觉提示,在 Robocasa-GR1-Tabletop 和 SimplerEnv 上分别带来 5% 和 8.3% 的提升¹。其二,上下文学习(in-context learning)在 VLA 场景中的有效性也已得到证实:Retrieval-VLA 通过检索增强配合上下文学习,让预训练 VLA 无需微调即可适配新任务²。从工程角度看,bbox 还是一个清晰的契约式接口:上游可以换更强的 VLM,下游可以换更强的分割模型,彼此无需感知对方的存在——VP-VLA 的实现同样采用了"VLM 出框 + 分割模型细化"的组合。
1.3. 三色 mask 的语义设计
分割得到的 mask 不会以原始形式交给 VLA,而是按语义染成三种颜色,画到观测图像上。
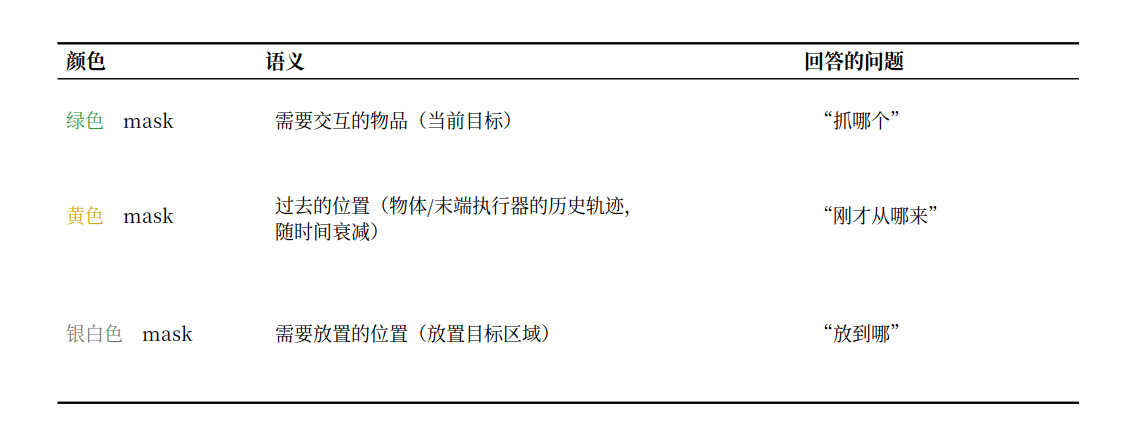
在我们的桌面场景实验中,高饱和度且与场景本色混淆较低的颜色更容易形成稳定的视觉提示,因此最终选用了绿色、黄色与银白色。每种颜色只承担一种语义,VLA 不需要理解颜色组合。
三色语义要生效,前提是 VLA 真的读得懂这些颜色。我们没有指望预训练模型自己领悟,而是对 magicVLA 做了基于 mask 的后训练:在带三色引导帧的演示数据上继续训练,把“绿色去抓、银白去放、黄色表示历史轨迹”这组语义固化进策略权重。这和 VP-VLA 训练时加入辅助视觉 grounding 目标、让策略学会利用视觉提示是同一个思路。视觉引导提供像素级 prompt,后训练保证模型读得懂这个 prompt,两者构成同一设计的两个部分。²
1.4. 时序信息的像素化
绿色轨迹替代了原本语义instruct的物品识别的功能。将需要抓取的物品直接置于视觉中,省去了instruct到物品像素的对齐。
银白色轨迹替代了原本语义对于移动地点的识别。将需要放置的位置置于视觉中,省去了VLA对于触达位置的理解对齐。
黄色轨迹则增加了VLA对于运动中的判断,和额外的短期记忆能力。VLA 策略通常只看单帧或很短的时间窗口,没有显式记忆,“物体刚才在哪、动了没有”对它不可见。我们把过去几帧的物体位置和末端执行器轨迹画进当前帧,旧轨迹随时间衰减变淡。时序信息被编码成了空间信息,历史变成了像素。
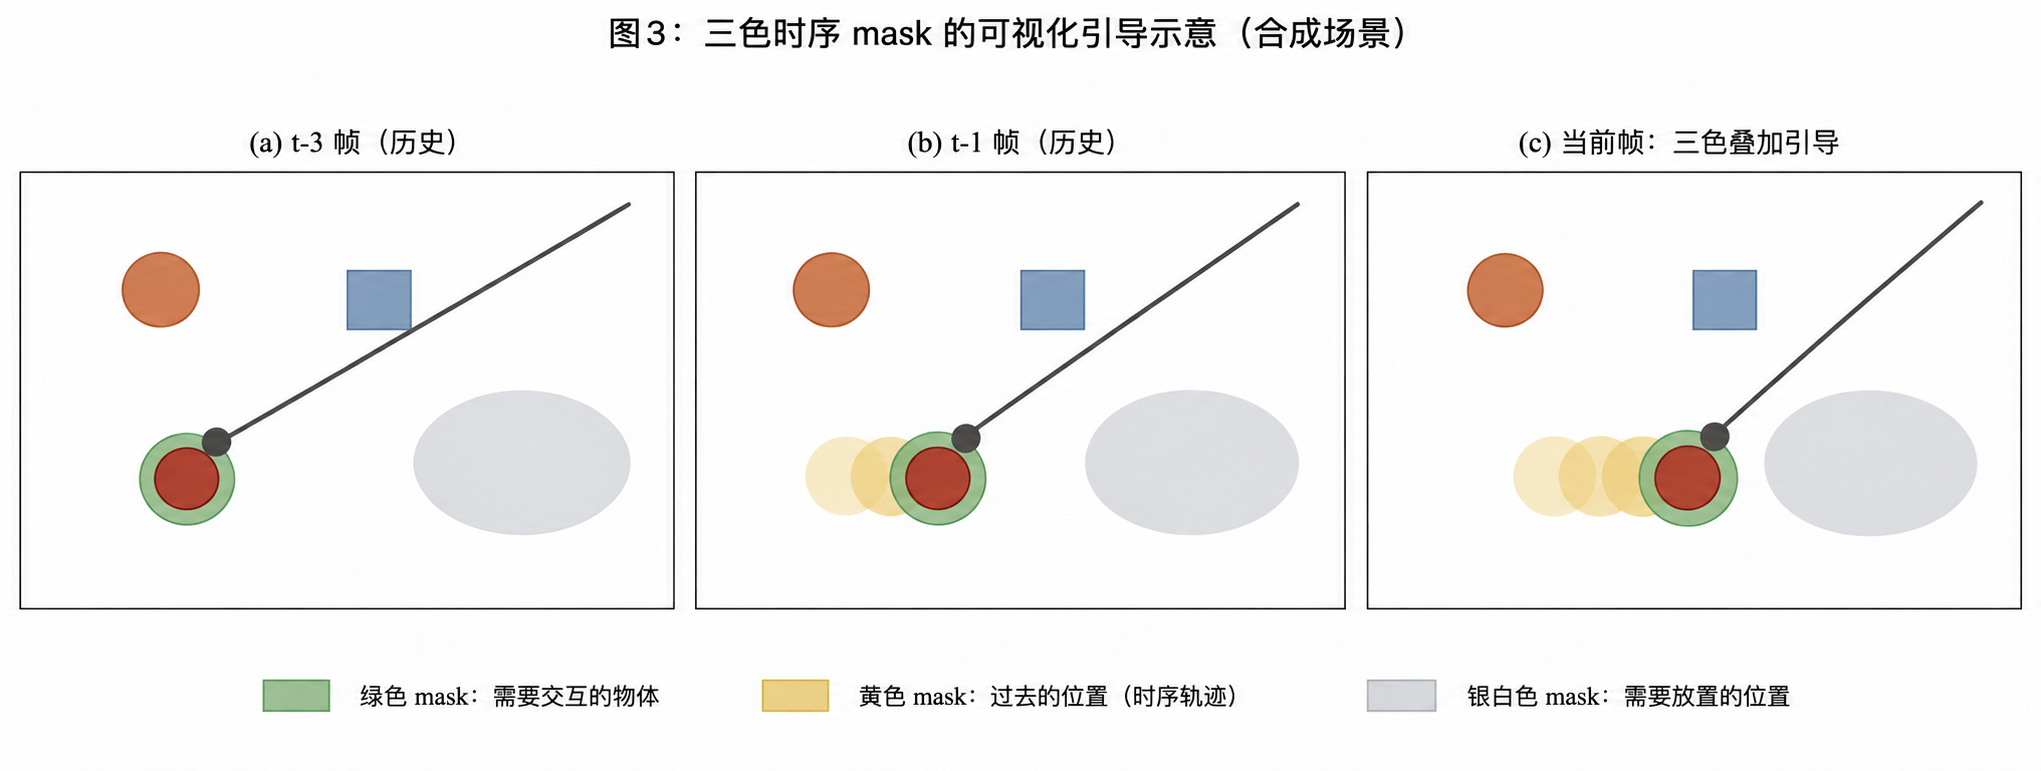
三色 mask 可视化
图 2 · 三色 mask 合成示例:绿色为当前交互目标,黄色为随时间衰减的历史轨迹,银白色为放置区域
2. VLA 后训练:赋予模型视觉引导跟随能力
2.1. 动机与设计目标
在三色 mask 的语义设计确定之后,三色通道与语义类别之间的映射关系即告冻结,成为后续数据生产与模型训练所依赖的固定“视觉协议”。此时剩余的核心问题是:如何让 VLA 模型理解并消费这套视觉协议——即在观测到叠加有三色 mask 的图像时,策略能够将各色通道解析为对应的语义信息(绿色:当前交互/抓取目标;银白色:目标放置区域;黄色:历史轨迹与时序信息),并生成与该视觉引导一致的动作序列。
需要强调的是,我们选择不修改 VLA 的网络结构,而是将 mask 语义完全编码在输入观测之中,通过数据侧的后训练让模型建立“颜色通道 → 语义信息 → 动作分布”的条件化映射。这样做的收益有三点:其一,mask 协议与模型架构解耦,后续调整语义设计时无需改动模型结构;其二,后训练在预训练 VLA 的通用操作能力之上增量进行,并通过混合原始数据尽可能降低其原有语言指令跟随能力的退化;其三,视觉引导与语言引导共用同一策略网络,两者可以自然组合——语言指定任务语义,mask 提供目标、放置区域与时序信息。
2.2. 视觉引导数据生产(Mixed Data Pipeline)
基于上述协议,我们使用 mixed 数据生产管线,在既有演示数据的基础上合成了一批带视觉引导的训练数据。具体流程如下:
(1)轨迹回放与 mask 合成。对既有真机/仿真演示轨迹逐帧回放,依据三色 mask 的语义设计,将对应的 mask 图案合成到各视角观测帧上:当前交互/抓取目标以绿色渲染,目标放置区域以银白色渲染,历史轨迹与时序信息以黄色渲染。经相机内外参投影后与原始 RGB 对齐,保证 mask 的空间位置与场景几何严格一致。
(2)多源混合。 合成数据与原始数据按比例混合,形成最终的混合数据集:
• 带 mask 数据:教授"视觉引导 → 动作"的条件化映射,是本阶段新增的核心数据;
• 无 mask 原始数据:防止模型对"mask 恒存在"产生过拟合假设,同时维持预训练获得的通用操作与语言跟随能力不退化。
(3)鲁棒性增强。为避免模型学成“背诵”固定 mask 图案,我们在合成阶段引入系统性扰动:mask 位置与形状的随机抖动、颜色通道的随机丢弃(channel dropout,迫使模型在部分语义缺失时仍给出合理动作),以及历史轨迹形态的多样化采样。此外混入一定比例的“冲突样本”——语言指令与 mask 引导指向不同目标的样本,使模型学习两者发生冲突时的优先级行为。
2.3. 能力目标与验证
后训练后的 VLA 具备视觉引导跟随能力,具体验证三个维度:
1. 引导跟随精度:给定语言指令 + 三色 mask,模型能否正确接近绿色目标区域、将物体放置于银白色目标区域,并利用黄色历史轨迹维持对短期运动状态的感知,以任务成功率与轨迹偏差进行度量;
2. 在线重定向:在 rollout 过程中动态更新 mask(如移动当前目标或目标放置区域),检验模型能否实时响应视觉引导的变化而无需重置任务;
3. 无引导退化检测:在不提供 mask 的原始任务上回归测试,确认通用操作能力与语言跟随能力未因后训练而下降。
由此,mask 语义设计(视觉协议)与 VLA 后训练(协议消费)构成完整闭环:前者定义了"人/系统如何向机器人表达空间约束",后者保证"机器人能够正确理解并执行该约束",为后续基于视觉引导的任务编排与人机交互奠定基础。
2.4. 评测结果
我们在 MolmoSpaces-Bench 上做了消融对比。基线是同一个 magicVLA 策略、同一套任务,唯一变量是观测里有没有视觉引导帧:
• ms-pick(单阶段抓取):成功率从 70% 提升到 94.4%,+24.4 个百分点;
• pick-and-place(先抓后放):成功率从 41% 提升到 84.7%,+43.7 个百分点。
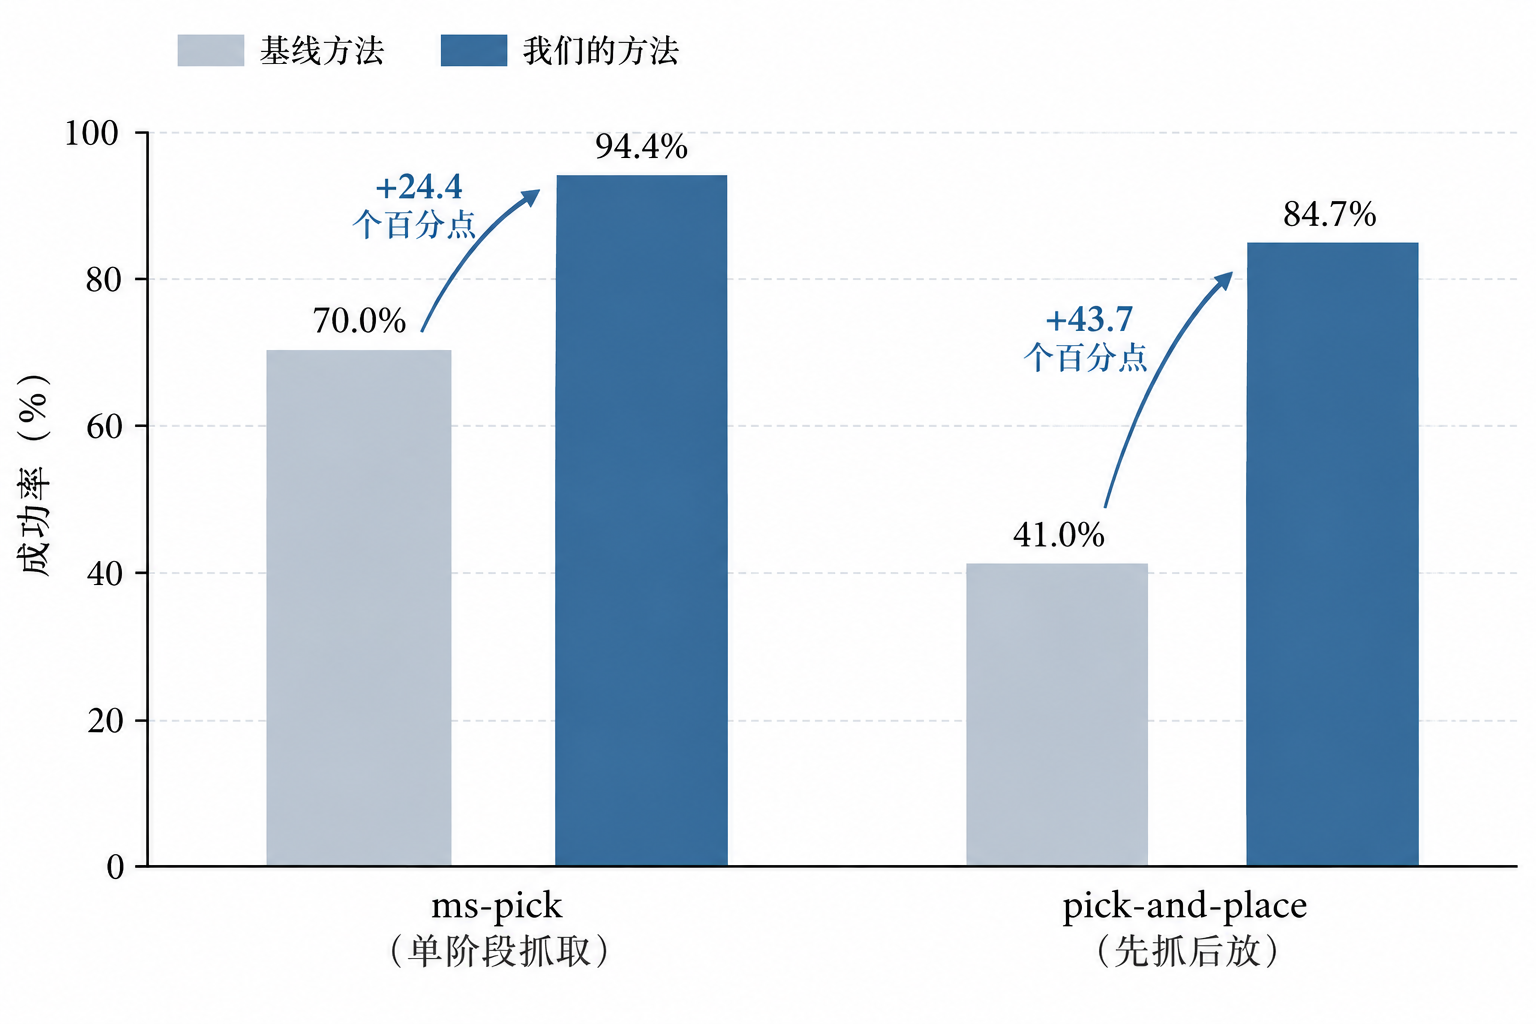
MolmoSpaces-Bench 评测结果
图 3 · MolmoSpaces-Bench 上的消融对比:视觉引导在两类任务上分别带来 +24.4pp 与 +43.7pp 的成功率提升。
在当前两类任务的对比中,包含抓取与放置两个阶段的 pick-and-place 获得了更大的绝对提升。一个可能的原因是,放置阶段需要回答“放到哪”,这类区域级 grounding 对纯语言指令更具挑战:例如“篮子”对应的是一个空间区域,而非单一可指认的物体;银白色 mask 则可以直接将目标放置区域呈现在观测图像中。因此,在本组实验中,视觉引导在放置阶段体现出了更明显的收益。
3. Magic-Brain 框架简介
3.1. 三层架构
Magic-Brain 是我们的具身 Agent 框架,采用三层架构:apps → gateway → agent_core。apps 层主要用于实现面向具体功能的 Agent,包括导航、抓取、交互和哨兵四类。其中,哨兵 Agent 主要负责主动式、触发式任务。四类 Agent 协同完成机器人算法能力的整合,将导航、抓取、交互与主动感知/主动响应能力组织为统一的具身智能体系统。
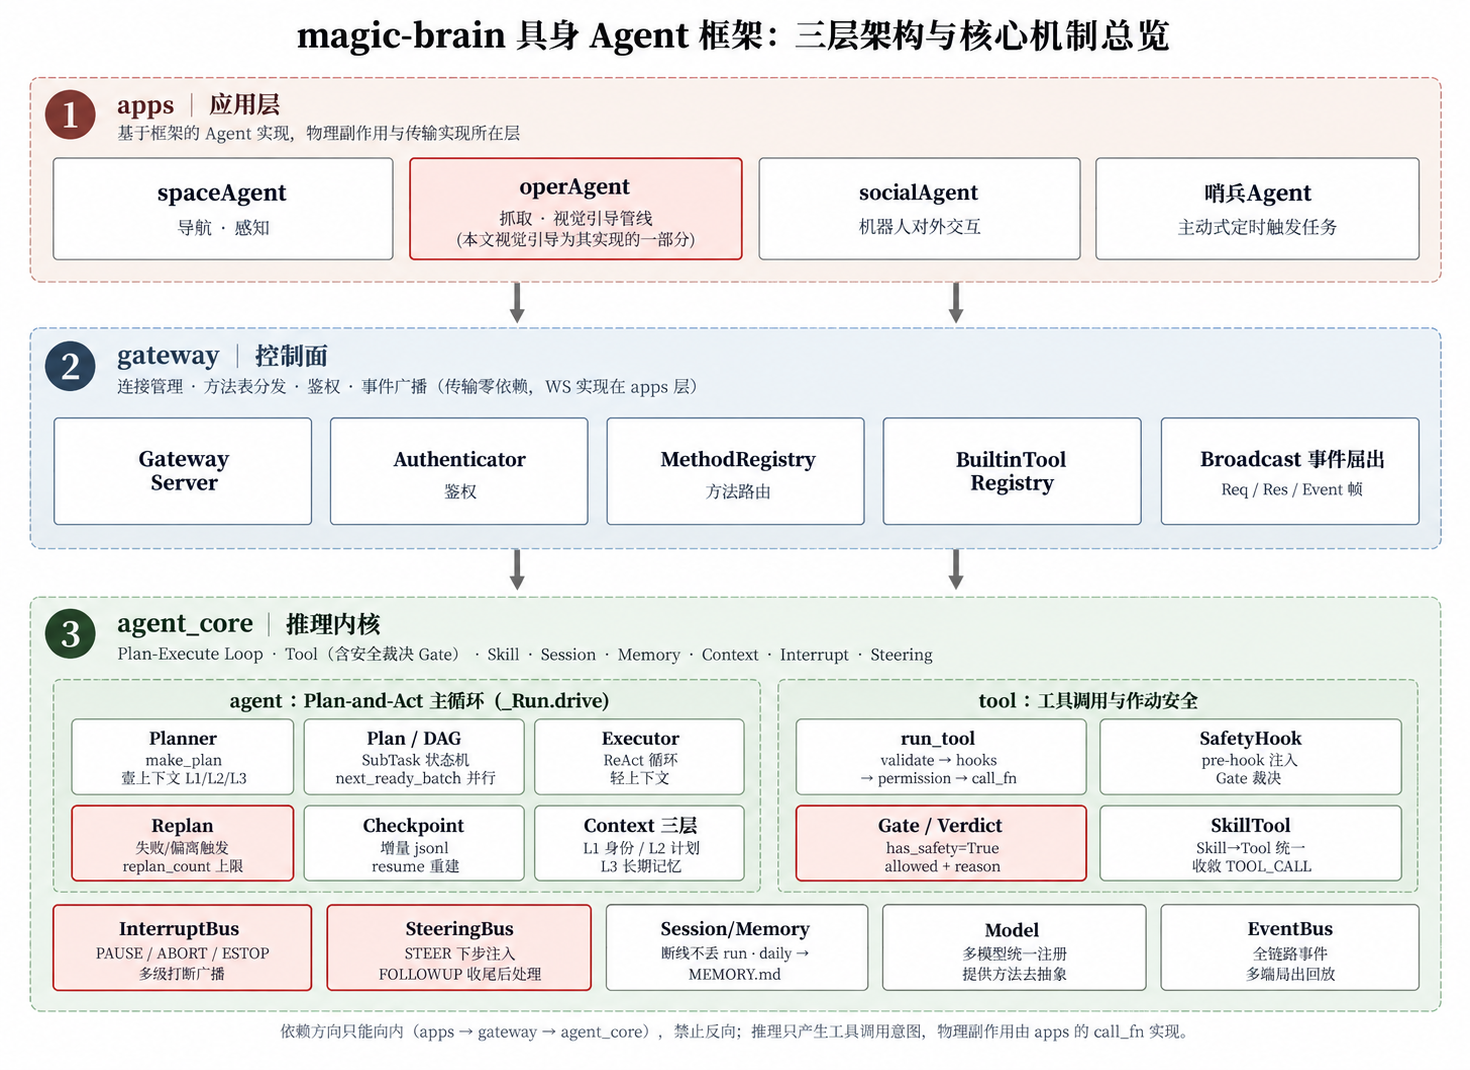
Magic-Brain 三层架构层级图
图 4 · Magic-Brain 的三层架构。
gateway 层负责连接管理、事件广播与鉴权,是支撑跨机器人本体与规模化部署的基础设施层。agent_core 则作为 Agent 框架的核心执行引擎,承载 Plan-and-Act、工具管理、Memory、Context 等 Agent 相关的核心机制。通过这种分层设计,同一套 agent_core 可以支撑 apps 层的多个功能型 Agent。
3.2. 计划、打断与重规划
主循环由 Plan-and-Act 驱动,遵循“规划 → 执行 → 观察 → 再规划”的闭环。子任务组织为 DAG,每个 SubTask 有 READY/BLOCKED/RUNNING/DONE/FAILED 五种状态,并通过依赖关系检查保证拓扑结构无环;运行时动态计算 READY 子任务批次,并使用 asyncio.gather 并发执行彼此独立的任务。
具身场景中,打断是常态。我们将 InterruptBus(PAUSE/ABORT/ESTOP)与 SteeringBus(STEER/FOLLOWUP)正交分开:前者表达“停”,后者表达“改主意”,两者语义不同,因此不共享通道。在作动安全方面,声明 has_safety=True 的工具会经过包含 SafetyHook 与 Gate.evaluate 裁决在内的五步工具管线。子任务状态为 FAILED 或 DEVIATED 时触发 replan,上限为 max_replans=3;checkpoint 的恢复粒度是子任务而非步骤,因为具身动作不可回滚——机械臂已经倒出去的水无法收回,能够重新执行的是任务。
回到开头的问题:我们没有让 VLA 变得更聪明,只是让它看见了该看什么。在具身系统里,“看见”往往不是感知模型的容量问题,而是信息以什么形式抵达的问题。语言说清“做什么”,像素说清“是哪个、在哪里”,把两路信息各交给擅长的模型,是我们目前找到的最省力的分工。
※ 参考文献
1. Wang, Z., Chen, Y., Liu, Y., Ye, J., Chen, P., Lu, C., Liu, S., Yu, B., Jia, J. “VP-VLA: Visual Prompting as an Interface for Vision-Language-Action Models.” arXiv:2603.22003, 2026. 提出把视觉标记(准星、bbox)叠加在观测图像上作为 VLA 的输入接口,System 2 的 VLM 规划器出标记、System 1 控制器消费标记,训练时加入辅助视觉接地目标。
2. Yang, J., Huang, W., Zhang, J., Hu, M., Guo, H. “In-Context VLA: Endowing Vision-Language-Action Models with Language via In-Context Post-Training and Agentic Tool Use.” arXiv:2608.05738, 2026. 指出自由文本 CoT 会损害 VLA 的低层控制,主张让 VLA 消费已接地的信息而非生成语言,做法是 in-context post-training 加 agentic tool use。
3. Zhang, Y., Wang, R., Lin, J., Wang, Z., Qi, X. “Retrieval-VLA: Training-Free In-Context Adaptation for Vision-Language-Action Models.” CVPR 2026. 通过检索增强与上下文学习,让预训练 VLA 无需梯度更新即可适配新任务。
4. Kim, et al. “MolmoSpaces.” arXiv:2602.11337, 2026. 具身评测基准,MolmoSpaces-Bench 包含 pick 与 pick-and-place 任务。